人工智能应用软件开发 从技术架构到落地实践
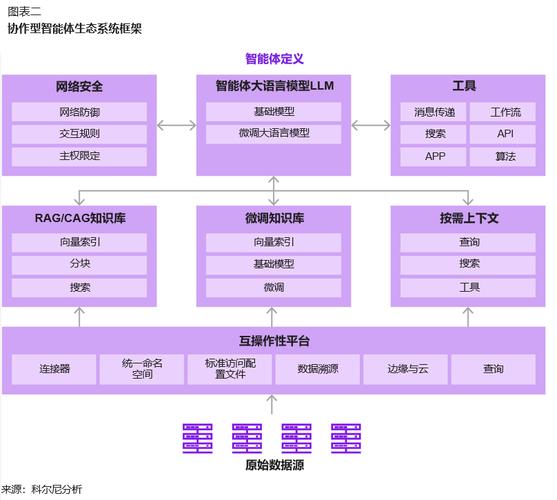
人工智能(AI)正从前沿研究快速走向千行百业,而AI应用软件作为承载智能能力的核心载体,其开发过程既延续了传统软件工程的严谨性,又引入了数据驱动、模型迭代等全新维度。本文围绕人工智能应用软件开发的关键环节展开讨论,旨在为开发者与团队提供一份系统性的实践参考。\n\n## 一、需求定义:从业务痛点到AI适用性评估\n\nAI应用软件开发的第一步并非写代码,而是判断“该不该用AI”。团队需要将业务问题拆解为可量化的目标,例如“将客服响应准确率提升至90%”或“把质检漏检率降低到1%以下”。同时要评估AI的适用边界:规则明确、数据充足、容错率合理的场景更适合AI介入。若问题本质是流程优化而非模式识别,传统软件方案可能更经济。只有在需求阶段完成这一过滤,后续投入才不至于偏离方向。\n\n## 二、软件架构设计:AI组件与传统系统的融合\n\nAI应用软件很少是“纯模型”的形态,它通常是模型服务与业务系统的组合体。典型架构包括数据层(采集、清洗、存储)、模型层(训练、推理、版本管理)、服务层(API网关、业务逻辑)和交互层(前端界面、移动端)。开发者的关键任务是把推理服务设计为可替换的组件——例如通过统一的API封装模型调用,避免业务代码直接依赖某一框架或某一版本模型;在此基础上引入A/B测试机制,使模型升级无需停机。}\n\n功能安全与合规设计应在架构阶段前置:对个人数据的调用进行最小化处理,对模型输出设置置信度阈值与人工兜底通道。这些设计虽然没有传统意义上的“复杂度”,却是AI软件可交付、可审计的必要条件。\n\n## 三、数据处理管道:用于训练与评测的高质量数据供给\n\n没有数据管道就没有AI软件。开发者需要设计一条贯穿数据接入、标注、清洗和版本管理的数据流:接入层负责多源异构数据的统一汇聚;标注环节通过标注平台与人机协作降低人工成本;清洗规则回灌到原始产物及线上采集的真实请求中,持续扩大可用数据池。尤其值得强调的是\}$评测数据集的独立维护**——让一个通常的做法却是从训练集中隔离出一份覆盖长尾场景的独立测试资源,用来判断数据漂移或缓存偏差。没有独立的评测口径,代码上线之后的系统便在近乎“无真相”的条件下逼近了风险区\\n\\n文本调整
如若转载,请注明出处:http://www.rxmtr.com/product/47.html
更新时间:2026-11-19 15:46:04